Temps de lecture estimé : 9 minutes
Points clés à retenir
- Pas de pénalité automatique pour la majorité des doublons non trompeurs
- Choisir entre 301, canonical, noindex ou réécriture selon le cas précis
- Comparer canonical déclarée et canonical sélectionnée dans Search Console
- Une URL canonique unique par contenu, alignée avec liens internes et sitemap
- Prioriser les corrections selon trafic, revenus et backlinks des URLs concernées
Duplicate content en SEO : définition et réalité du risque
Le duplicate content SEO désigne des contenus identiques ou très proches accessibles via plusieurs URLs distinctes. J’ai vu passer ce cas plusieurs fois en mission, et il concerne rarement du plagiat volontaire. Le plus souvent, c’est un problème d’architecture ou de CMS mal configuré.
Il faut distinguer trois situations bien différentes. Le contenu strictement identique concerne une même page accessible sous plusieurs adresses. Le contenu très similaire touche des fiches produits ou articles qui partagent 80 % de leur texte. La simple répétition de gabarit, elle, vient d’un template qui génère des blocs identiques sur des centaines de pages sans texte unique.
On distingue aussi le duplicate content interne, propre à un même domaine, du duplicate content externe, quand un contenu est repris sur un autre site. La duplication liée aux URLs s’ajoute à ces deux cas : plusieurs adresses techniques pointent vers le même contenu sans qu’aucun texte ne soit dupliqué manuellement.
Concrètement, ce que ça change c’est la façon dont Googlebot traite ces URLs. Le moteur regroupe les versions équivalentes en clusters, puis sélectionne une URL canonique pour l’indexation. Ce choix ne dépend pas uniquement de vos préférences déclarées.
Soyons clairs : il n’existe pas de pénalité automatique pour la majorité des cas non trompeurs. Google Search Central le précise dans sa documentation officielle. Le vrai risque, c’est la dilution des signaux et une mauvaise sélection d’URL, pas une sanction manuelle systématique.
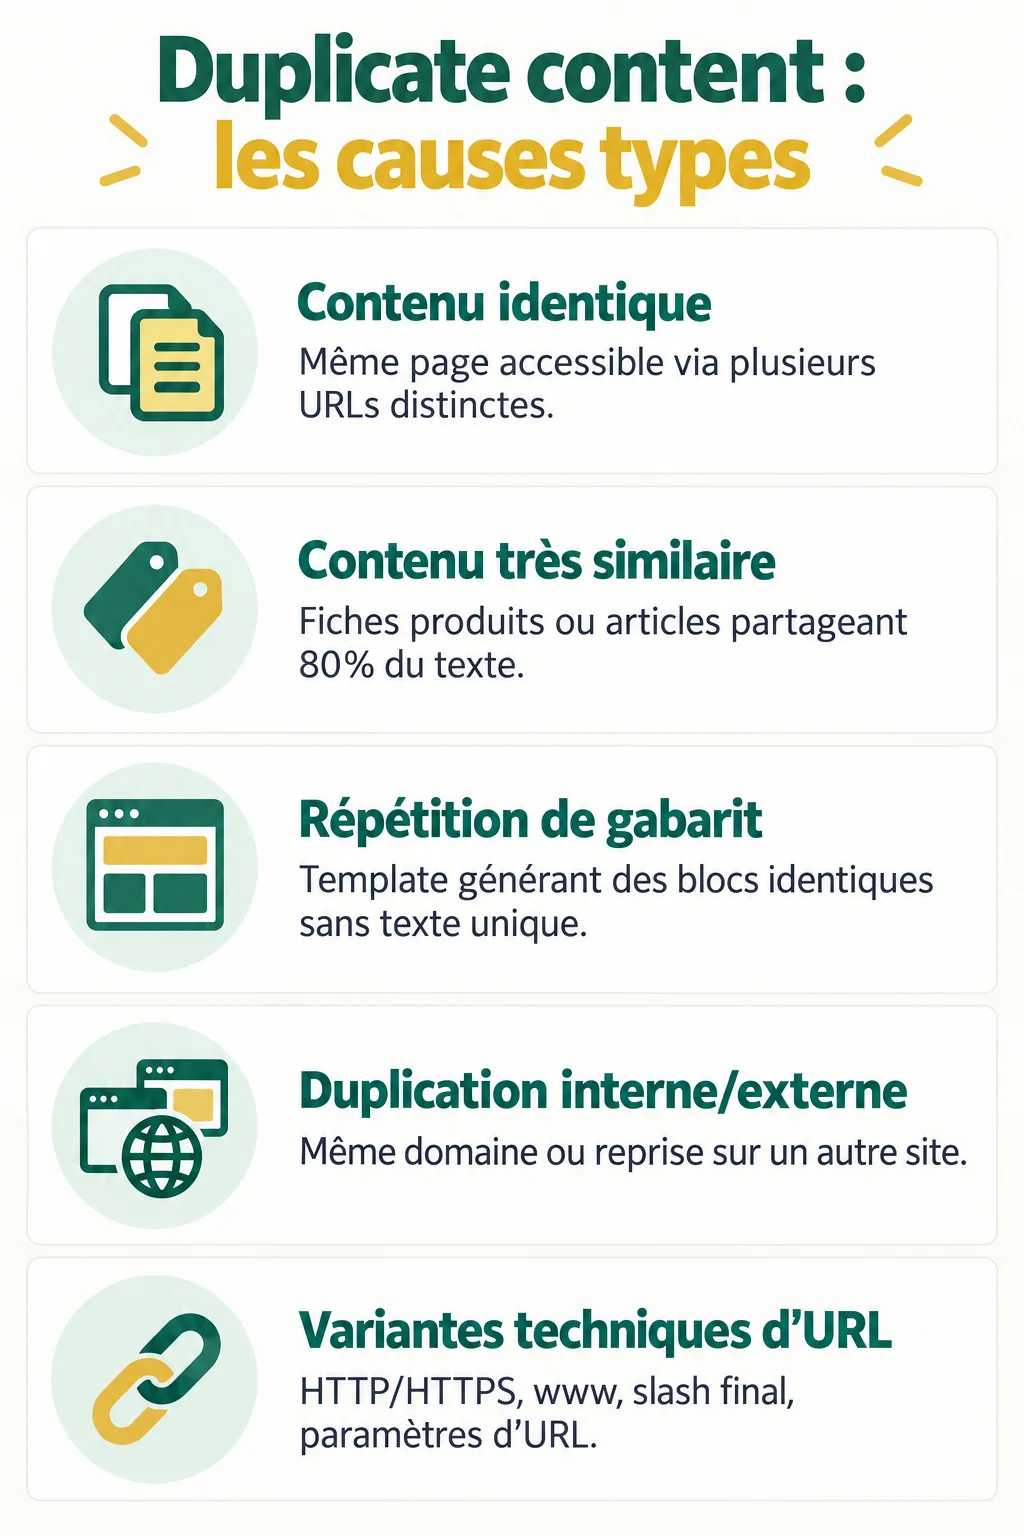 Ouvrir l’infographie en grand
Quelles sont les causes les plus fréquentes de contenu dupliqué ?
Dans les faits, les causes se regroupent en trois familles récurrentes : les paramètres d’URL, les versions techniques d’adresse, et les gabarits de CMS. Structurer l’audit par origine technique est plus efficace que de partir de la seule similarité textuelle.
- Variantes de protocole et de domaine : HTTP/HTTPS, www/non-www, présence ou absence du slash final, index.html en suffixe
- Paramètres d’URL : tri des résultats, filtres, pagination, tracking publicitaire, recherche interne
- E-commerce : fiches produits en déclinaisons couleur ou taille, descriptions fournisseur reprises telles quelles, pages de catégories qui se chevauchent
- Syndication et republication : contenus repris sur plusieurs domaines, scraping non autorisé
Un classique que je retrouve chez mes clients e-commerce : la même description fabricant collée sur des dizaines de fiches produits. Aucune réécriture, aucune différenciation. Résultat, Google ne sait plus laquelle privilégier.
Quels effets le duplicate content peut-il avoir sur le référencement ?
Quand plusieurs URLs répondent au même besoin, Googlebot peut indexer une version différente de celle que vous souhaitiez mettre en avant. C’est souvent là que naît la frustration : votre page cible n’apparaît pas, une variante technique la remplace dans les résultats.
La dilution des signaux est l’autre effet concret. Les liens internes, les backlinks externes, la présence dans le sitemap XML et les données de performance se répartissent entre plusieurs URLs au lieu de se concentrer sur une seule. Autant vous le dire tout de suite : cette dispersion affaiblit la version qui devrait ranker.
On parle aussi de cannibalisation apparente lorsque plusieurs pages proches concurrencent la même requête. Ce n’est pas toujours un vrai duplicate content, mais le symptôme se ressemble : positions instables, alternance d’URLs dans les résultats d’une semaine à l’autre.
Côté utilisateur, l’effet est direct. Un visiteur qui tombe sur une page filtrée sans contenu propre repart plus vite. Pour un site marchand, cela se traduit par un taux de conversion en baisse sur les pages dupliquées.
Comment détecter le duplicate content sur un site ?
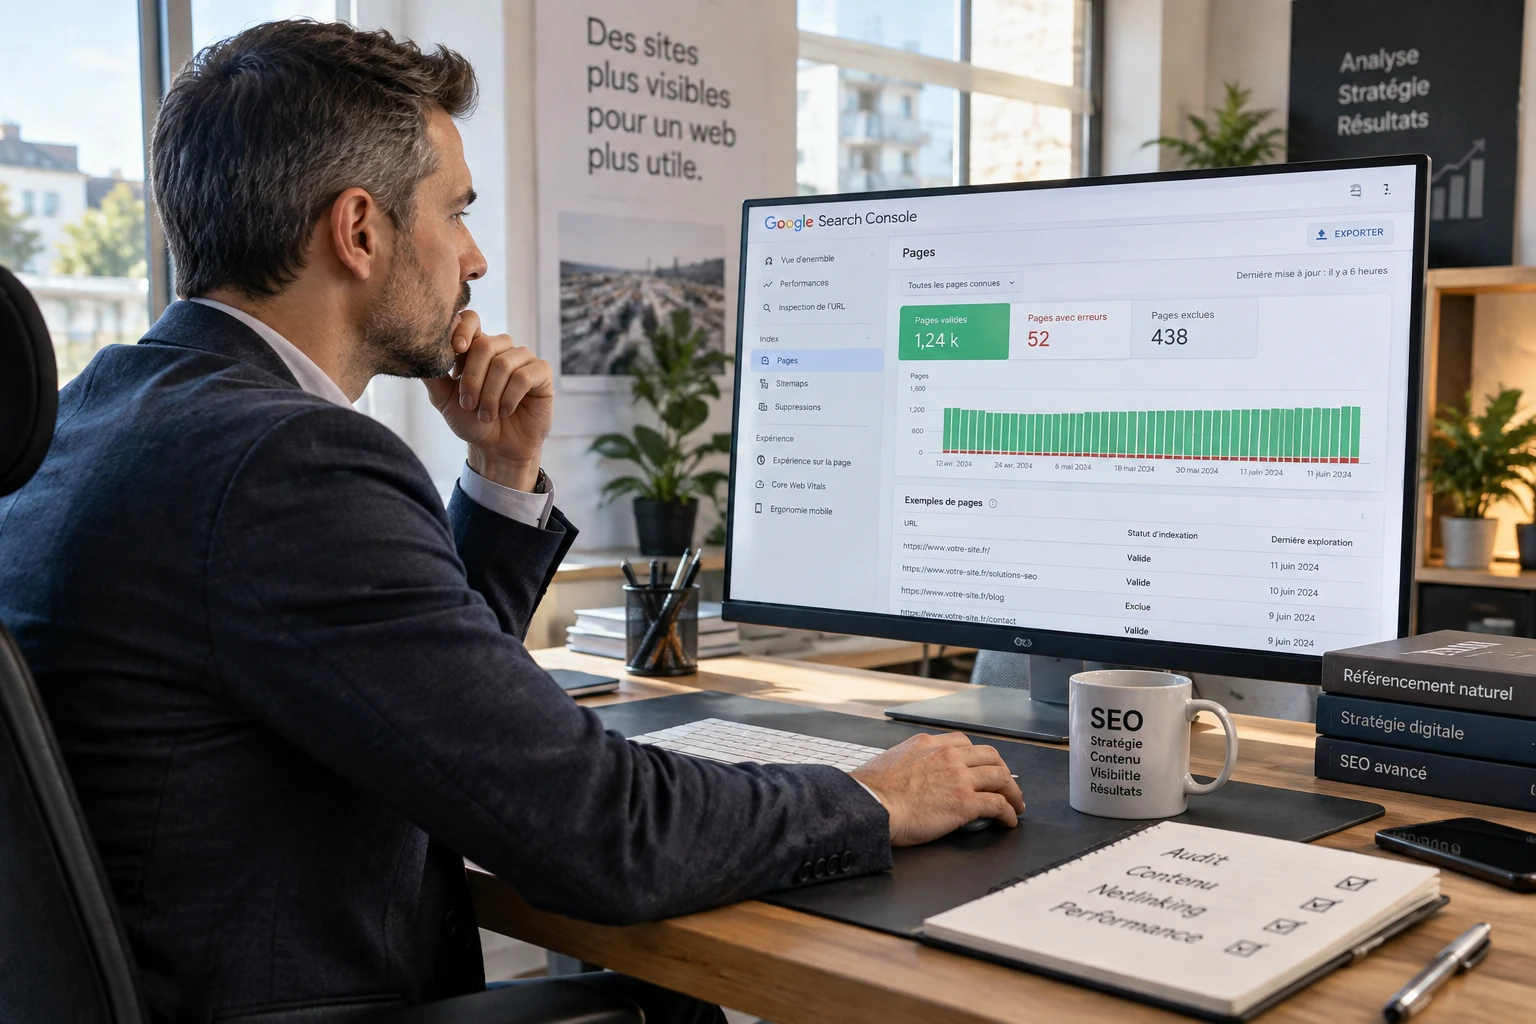
On oublie souvent un détail qui change tout : la Google Search Console affiche directement les statuts « Doublon » dans le rapport de couverture. C’est le point de départ, pas une option.
- Comparer l’URL canonique déclarée par l’utilisateur et l’URL canonique sélectionnée par Google — un contrôle prioritaire avant toute modification technique
- Crawler le site pour repérer les titres et meta descriptions identiques sur plusieurs adresses
- Vérifier le sitemap XML et la cohérence des liens internes vers les URLs jugées de référence
- Analyser les logs serveur si disponibles, pour voir quelles URLs Googlebot explore réellement
Pour visualiser une approche pratique de correction côté e-commerce, cette vidéo de SearchLogistics détaille trois méthodes concrètes pour éliminer le duplicate content sur une boutique en ligne.
Enfin, l’opérateur site : reste un outil simple pour repérer une copie externe. Prenez une phrase distinctive de votre page, recherchez-la entre guillemets, et vérifiez si un autre domaine l’a reprise sans autorisation.
Choisir la bonne solution selon le type de doublon
C’est un classique que je retrouve chez mes clients : ils appliquent une balise canonical partout, sans se demander si une redirection ou un noindex serait plus adapté. Chaque cas de doublon appelle une solution précise.
- Redirection 301 : pour une URL obsolète, une ancienne version après migration, ou un doublon qui n’a plus aucune raison d’exister
- Balise rel= »canonical » : pour des variantes nécessaires côté utilisateur, comme un tri ou un filtre qu’on veut garder accessible sans l’indexer séparément
- Noindex : pour des pages utiles à l’internaute mais sans valeur propre à indexer, sous réserve qu’elles restent crawlables
- Réécriture et différenciation : quand deux pages doivent se positionner sur des intentions de recherche distinctes plutôt que fusionner
Réduire la correction à « ajoutez une balise canonical » est une erreur fréquente. La balise canonical n’est qu’un signal parmi d’autres, pas une commande absolue que Google exécute sans discussion.
Mettre en place une canonicalisation cohérente
Google Search Central identifie deux signaux forts pour indiquer une version préférée : la redirection et la balise rel= »canonical ». La présence dans le sitemap XML n’est qu’un signal faible, qui soutient la démarche sans remplacer une canonical correcte ni des liens internes cohérents.
La règle de base reste simple : une URL canonique par contenu, absolue, indexable et pertinente, déclarée dans le head de la page. Cette URL doit ensuite être alignée avec les redirections en place, les liens internes du site, le sitemap XML et, pour les sites multilingues, le balisage hreflang.
Ne canonicalisez jamais vers une URL elle-même redirigée, bloquée au crawl ou hors sujet. C’est l’erreur la plus fréquente que je corrige en audit : une chaîne de canonicals qui se contredit d’une page à l’autre.
Dans mon expérience, les erreurs les plus fréquentes sont les canonicals contradictoires entre deux pages qui se pointent mutuellement, les chaînes de redirection trop longues, et les pages quasi identiques sans canonical du tout. L’ancien outil de gestion des paramètres d’URL de Search Console a été retiré en 2022 : mieux vaut aujourd’hui travailler l’architecture, les canonicals et les règles d’indexation directement.
Cas pratiques : e-commerce, blog et sites internationaux
Sur une boutique en ligne, les déclinaisons couleur ou taille posent souvent question. Dans les faits, une déclinaison sans texte propre doit rester non indexable, avec canonical vers la fiche produit principale. Une déclinaison qui reçoit du trafic spécifique et mérite sa propre visibilité peut, elle, rester indexable avec un contenu différencié.
Les filtres et facettes suivent la même logique : indexables uniquement s’ils ciblent une intention de recherche réelle, comme « chaussures de running homme taille 42 ».
Sur un site éditorial, les articles proches, les pages de tags et les archives génèrent souvent du duplicate content passif. Une page imprimable, par exemple, doit être en noindex si elle reprend le contenu d’un article existant sans rien apporter de plus.
La syndication de contenu reste légitime quand elle est encadrée. Le site qui republie doit pointer une balise canonical vers l’article d’origine, ou à défaut créditer clairement la source. Pour les sites internationaux, le hreflang et le canonical doivent travailler ensemble : chaque version linguistique garde sa propre canonical, tandis que le hreflang indique à Google quelle version servir selon la langue et la région de l’internaute.
Plan d’action pour corriger durablement le contenu dupliqué
Autant vous le dire tout de suite : corriger le duplicate content sans méthode, c’est perdre du temps. Voici l’ordre que j’applique en mission.
- Inventorier les clusters d’URLs dupliquées et les prioriser selon le trafic, le revenu généré et les backlinks reçus
- Définir une URL de référence unique pour chaque intention de recherche identifiée
- Déployer les redirections, canonicals ou noindex selon la matrice décisionnelle du cas concerné
- Demander une nouvelle exploration des pages stratégiques via Search Console, une par une, car la fonction est soumise à des quotas
- Suivre l’évolution de l’indexation dans les semaines suivantes et verrouiller les règles côté CMS pour éviter que le problème ne revienne
Pour visualiser des cas d’usage supplémentaires, cette vidéo de Neil Patel détaille une stratégie de gestion du duplicate content côté contenu et architecture.
Questions fréquentes
Une balise canonical empêche-t-elle le duplicate content ?
Non. La balise canonical est un signal, pas une instruction absolue. Google peut choisir une autre URL comme référence si les signaux contradictoires. Liens internes, sitemap, contenu réel. Pointent ailleurs.
Quelle est la différence entre une redirection 301 et une balise canonical ?
La redirection 301 renvoie visiteurs et moteurs vers une nouvelle URL, l’ancienne cessant d’exister. La balise canonical laisse l’ancienne URL accessible mais indique à Google quelle version indexer en priorité.
Comment corriger « Google a choisi une autre page canonique que celle déclarée » ?
Vérifiez d’abord la cohérence des liens internes vers l’URL souhaitée, puis contrôlez qu’elle n’est pas elle-même en concurrence avec une version quasi identique. Alignez ensuite canonical, sitemap et redirections avant de redemander une exploration.
Peut-on avoir plusieurs URLs avec le même contenu sans pénalité Google ?
Oui, tant que la duplication n’est pas trompeuse. Google Search Central confirme qu’il n’y a pas de pénalité automatique : le risque réel est une mauvaise sélection d’URL et une dilution des signaux, pas une sanction manuelle sur le duplicate content SEO.